|
<< Показать Оглавление >> Получение аудиоданных от синтезатора речи (TTS) |

|
|
<< Показать Оглавление >> Получение аудиоданных от синтезатора речи (TTS) |
|
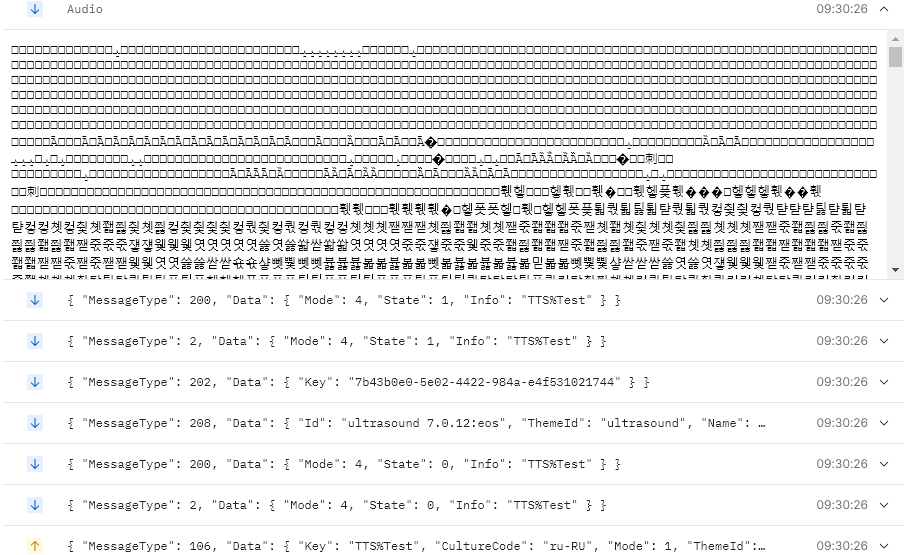
Звуковые данные передаются клиентскому приложению по websocket в пакетах типа binary.
Сервер синтезирует звук (TTS) в формате PCM-16, с частотой дискретизации 22050 Гц (mono PCM signed 16-bit little-endian).
 |
При работе через Postman пакет бинарных данных получается в кодировке Base64. Возможно, вам потребуется преобразовать его в hex для последующего использования. |